Webnevisan به یک اپلیکیشن نیاز داشت تا هر ویژگی یک لپتاپ را قبل از ارسال تست کند — از جمله هر پورت فیزیکی. اما تست یک پورت ابتدا نیازمند دانستن این است که وجود دارد و کجاست، و همین بخش سخت ماجرا از آب درآمد. هر لپتاپ متفاوت است، و اپلیکیشن باید روی هر مدلی که سروکلهاش پیدا میشد کار میکرد.
چالش: گرفتن فهرستی درست و کامل از پورتهای یک لپتاپ خاص و موقعیت آنها — دستورات سیستمعامل و APIهای اطلاعات سیستمی پاسخهای قابلاعتمادی نمیدادند، و این کار برای Webnevisan بود، پس باید واقعاً در محیط عملیاتی هم جواب میداد، نه فقط روی دستگاه تست من.
تلاش اول: اسکرِیپ کردن نقدها
اپلیکیشن از قبل اطلاعات سیستمی لپتاپ — برند، مدل، و بقیه — را از بخشهای دیگر فرآیند تست داشت. پس اولین برنامه استفاده از همان بود: یک خزندهی Python + Selenium که سایتهایی مثل NotebookCheck را برای نقد آن لپتاپ جستوجو میکرد، صفحه را باز میکرد و بخش اتصالات را پیدا میکرد، جایی که نقدنویسان از هر پورت عکس میگیرند و آن را توضیح میدهند.
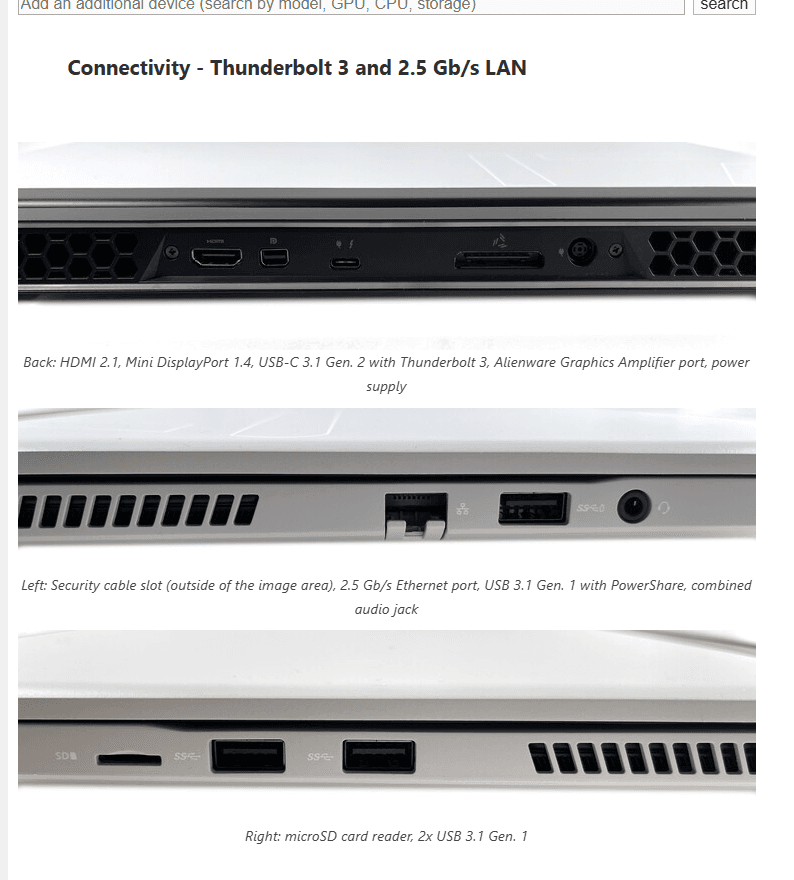
مشکل، پوشش بود. خیلی از لپتاپها اصلاً روی آن سایتها نقدی نداشتند. وقتی هم داشتند، نوشته همیشه پورتها را کامل پوشش نمیداد، و توضیحات دربارهی اینکه چهچیزی روی کدام طرف است یکدست نبودند — بهاندازهای که برای بخشی از مدلها داده را ناقص یا کاملاً غلط میکرد.
تلاش دوم: مستقیم سراغ راهنمای تولیدکننده
ایدهی بعدی: رد شدن از نقدهای شخصثالث و کشیدن PDF راهنمای کاربر مستقیماً از سایت خود تولیدکننده، بر اساس شمارهی سریال لپتاپ بهجای برند/مدل/پردازنده — جستوجوی سریال اصلاً مشکلی نداشت.
نکته این بود که سایتهای تولیدکنندگان بیشتر اپلیکیشنهای سمت کلاینت هستند که حول تعامل کاربر ساخته شدهاند — کلیک کردن در یک فرآیند پشتیبانی — نه صفحات استاتیکی که بشود مثل یک سایت نقد، fetch و پارس کرد. این را بهصورت یک سرویس FastAPI که Selenium را هدایت میکرد ساختم، اما Selenium راه خوبی برای منتظر ماندن برای آن تعاملها نداشت. از قبل نمیدانستم یک کلیک چقدر طول میکشد تا نتیجه بدهد، پس تنها گزینه sleepهای ثابت بود — و بهاندازهی کافی sleep کردن برای اطمینان، API را دردناک کند میکرد.
موتور خزنده را به یک API مبتنی بر Express.js و Playwright تغییر دادم. auto-waiting داخلی Playwright — که منتظر خود عنصر یا رویداد شبکه میماند بهجای یک تأخیر حدسی — کندی را کاملاً حل کرد. وقتی PDF راهنما پیدا میشد، یک PDF reader بخش پورتها را از آن استخراج میکرد، و یک پایگاهدادهی MySQL نتیجه را کش میکرد، پس یک فراخوانی API دیگر برای سریال متفاوتِ همان مدل، کل خزش را تکرار نمیکرد.
بلاکشدن در مقیاس
کش کردن کار تکراری را کم کرد، اما تعداد خام درخواستهایی که به سایتهای تولیدکننده میخورد هنوز زیاد بود، و مستقیم به دفاعهای ضدبات و بلاکهای منطقهای آنها برخورد کرد. سرور را به یک منطقه در آمریکا منتقل کردم و یک محیط دسکتاپ کامل نصب کردم تا Playwright بتواند headed اجرا شود بهجای headless — نزدیکتر به یک کاربر واقعی، سختتر برای شناسایی بهعنوان بات.
این برای مدتی جواب داد. بعد همان دفاعها به آن هم رسیدند، و نه تعویض DNS و نه مسیردهی از طریق پروکسی بدون توجه مداوم و دستی دوام آوردند — مراقبتی بیشتر از آنچه این کار توجیه میکرد.
بین مرورگر headed و انتظار برای دیدن اینکه چطور دوام میآورد، این مرحله تنظیمات سرور زیادی را پشت سر گذاشت — اندازهگیری CPU و RAM برای اجرای چند نمونهی headed کرومیوم بدون خفگی، و تنظیم بالا و پایین آن بیش از یک بار در تلاش برای دوام آوردن بیشتر از بلاککنندههای بات.
چرخش: توقف اسکرِیپینگ، شروع دیدن
در آن نقطه، روش اسکرِیپینگ سقفی داشت که نمیتوانستم با زیرساخت از آن عبور کنم. پس دیگر از وبسایتها جواب نخواستم و تصمیم گرفتم بهجایش مستقیم از روی عکس بخوانمش: آموزش یک مدل بینایی ماشین که به چند عکس از یک لپتاپ نگاه میکند و خودش پورتها را تشخیص میدهد. بازگشت به FastAPI، که برای سرو کردن یک مدل خیلی مناسبتر از هدایت یک مرورگر است.
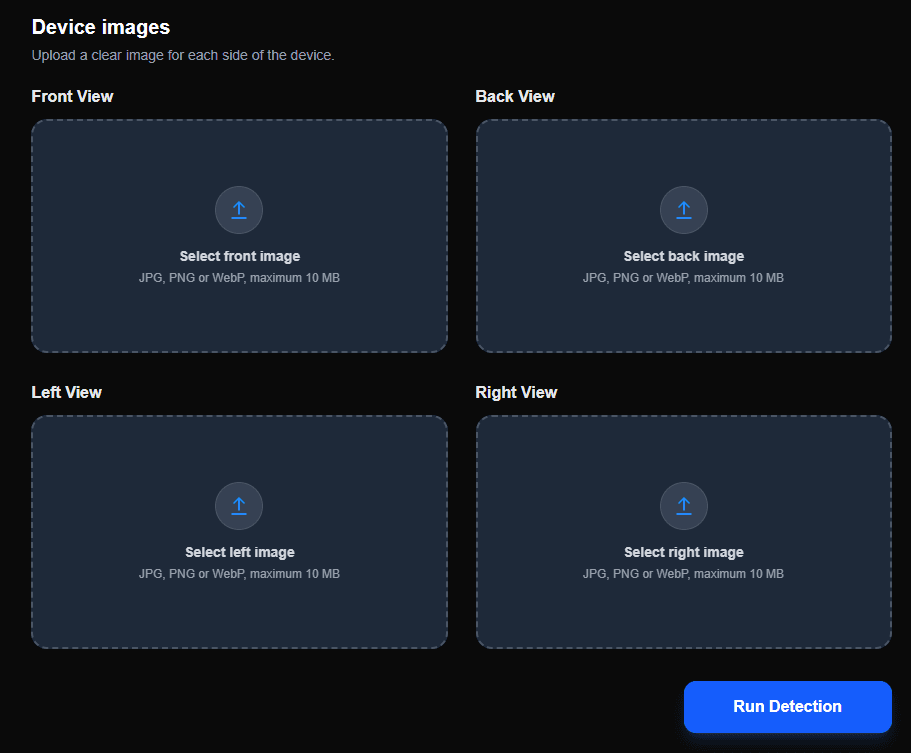
برنامه: پذیرفتن چهار عکس از یک لپتاپ — جلو، پشت، چپ، راست — اجرای تشخیص روی هرکدام، و برگرداندن یک JSON ساختاریافته از اینکه دقیقاً چه پورتی کجاست.
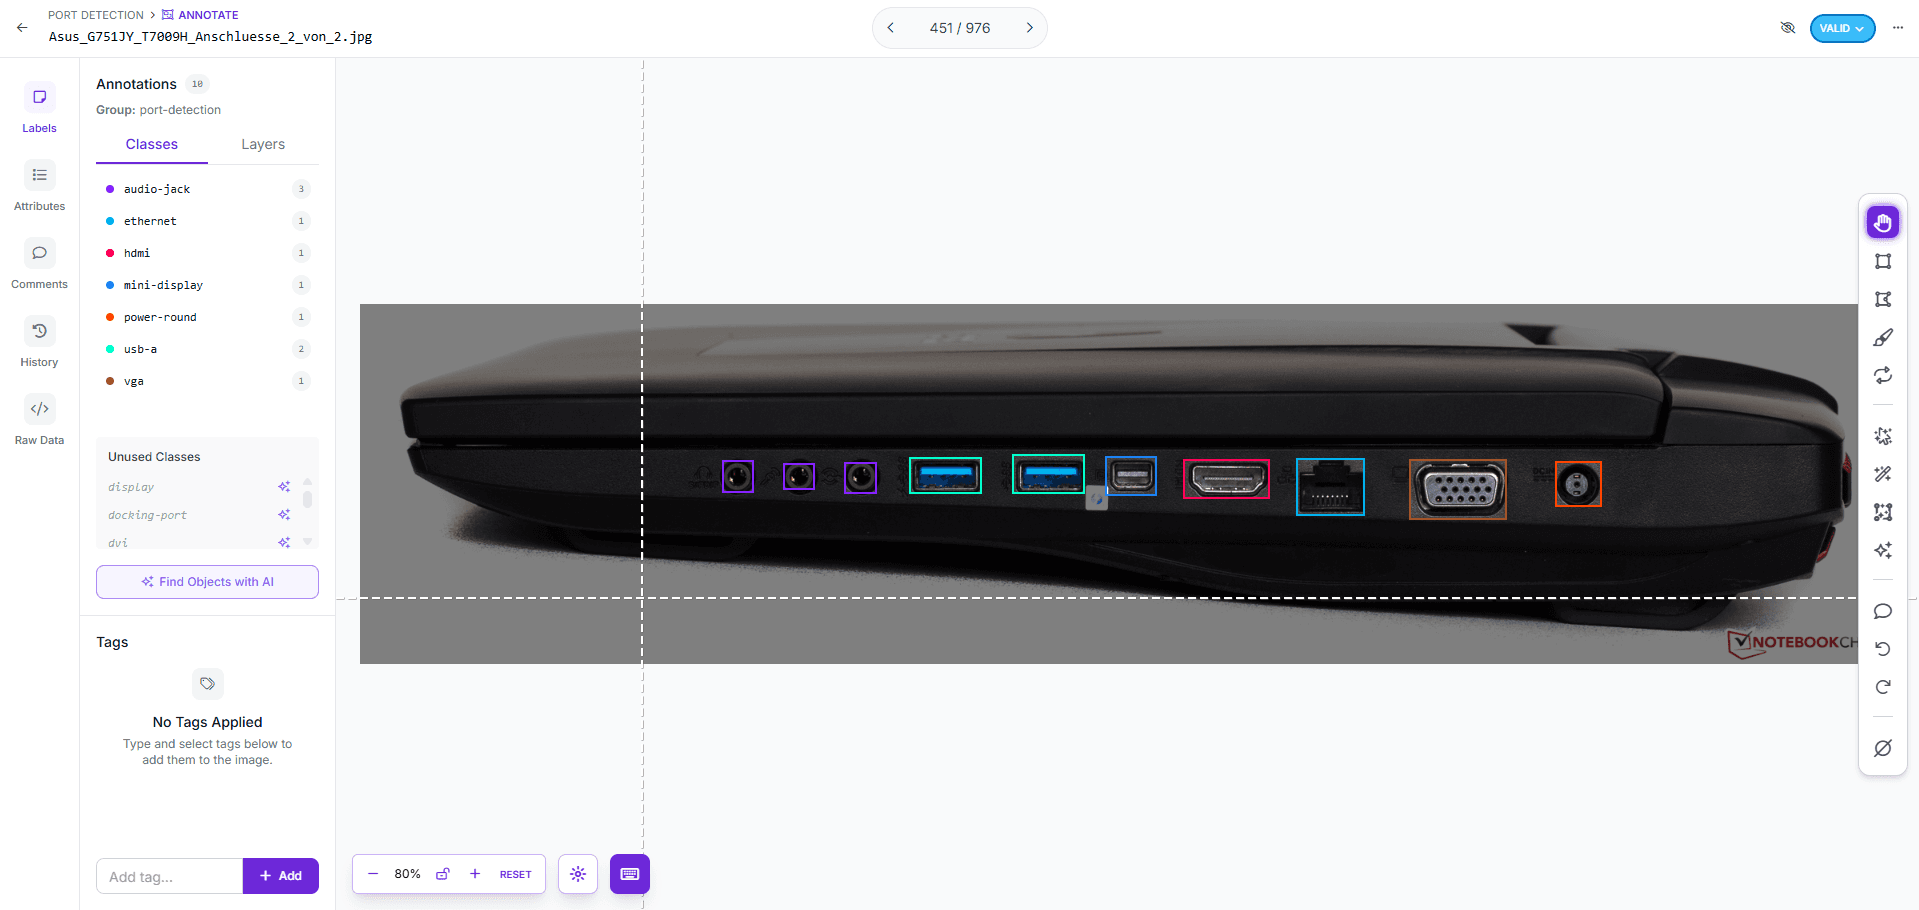
ساختن دیتاست
کلاسهای پورتی که واقعاً لازم داشتم را تعیین کردم — چیزهایی مثل USB-A، HDMI، اترنت، جک صدا، برق، VGA، مینیدیسپلیپورت — بعد مقدار واقعاً خستهکنندهای وقت صرف جستوجوی عکس پورت لپتاپ کردم، بیش از هزار تا، و همه را دستی در Roboflow برچسب زدم.
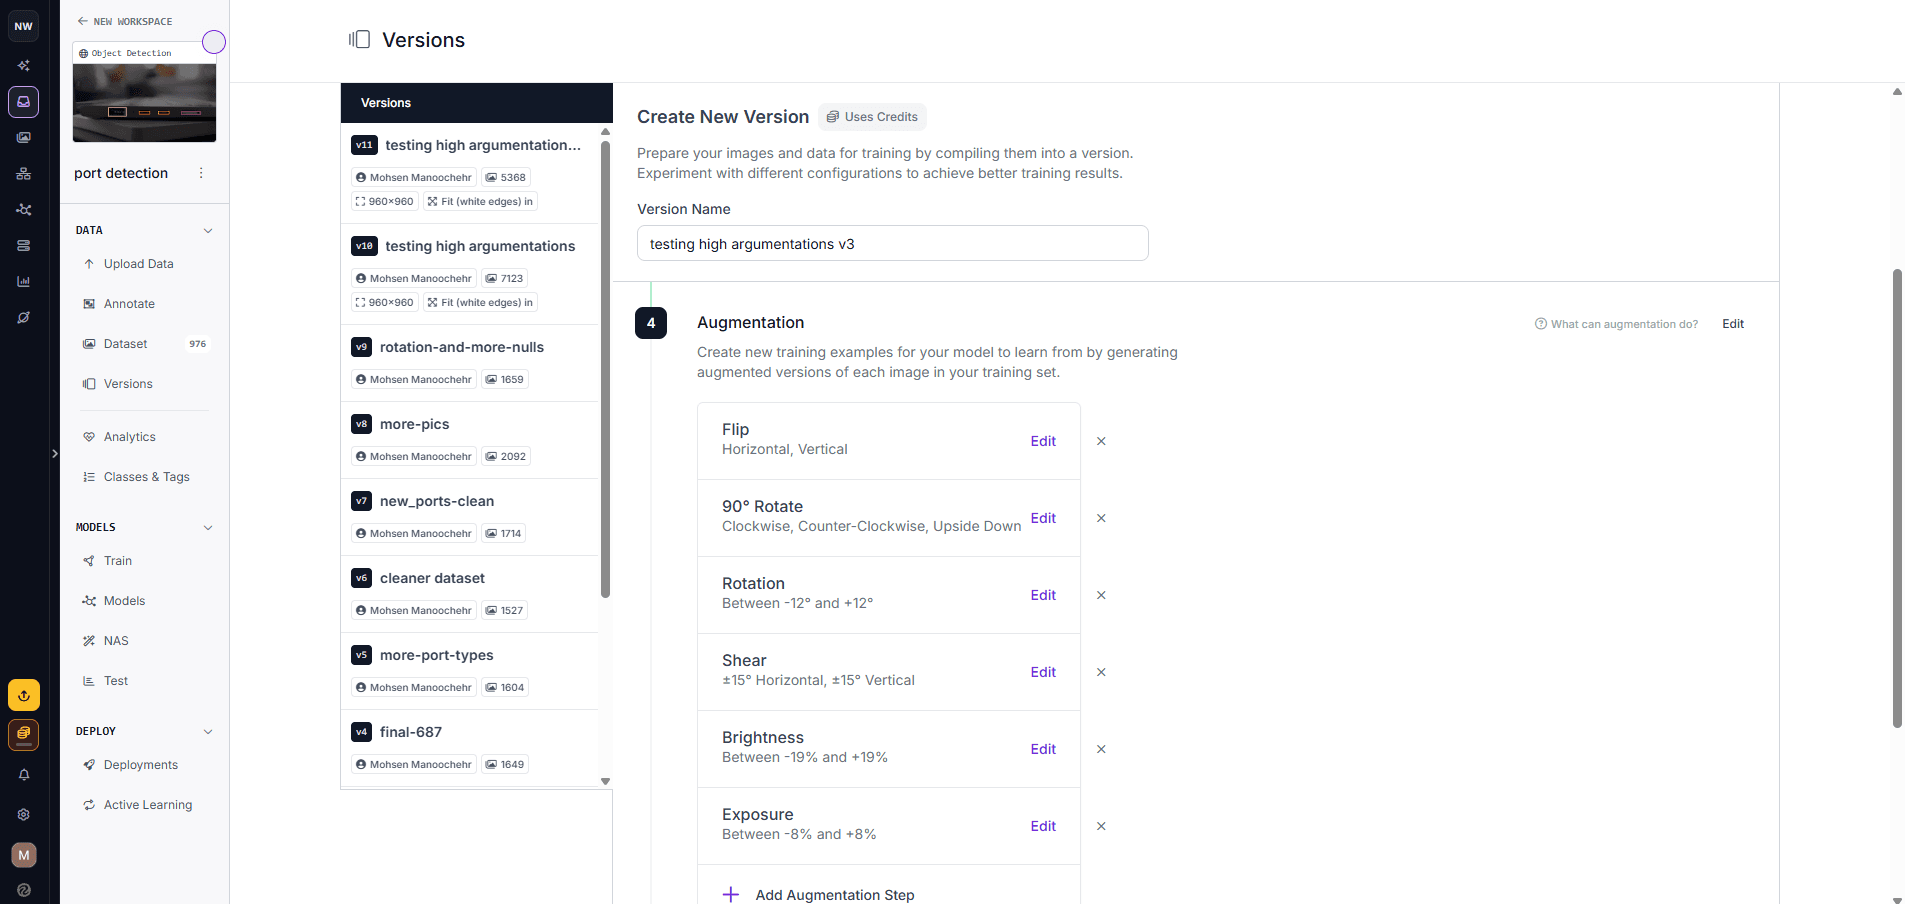
بیش از ده نسخهی دیتاست طول کشید تا به آن برسم — پاکسازی مجموعه، اضافه کردن تصاویر بیشتر، اضافه کردن کلاسهایی که جا انداخته بودم، و اضافه کردن تصاویر null بدون هیچ پورتی تا مدل یاد بگیرد چه چیزی را نادیده بگیرد، نه فقط چه چیزی را پیدا کند.
آموزش، شکست، بازآموزی
- عکسهای کج یا چرخیده در ابتدا تشخیص داده نمیشدند — با اضافه کردن augmentation چرخش و شیر حل شد، نه صرفاً با ریختن عکس خام بیشتر روی مدل.
- مثبتکاذب روی سطوح سادهی لپتاپ — با تصاویر null که هیچ پورتی برای تشخیص نداشتند حل شد.
- نورپردازی ناسازگار در عکسهای منبع — augmentation روشنایی و اکسپوژر این شکاف را بست.
- خود فهرست کلاسها بیش از یک بار بازبینی شد چون انواع پورت لبهای در داده ظاهر میشدند.
- تقسیمبندی صریح train/valid/test، هرکدام با پیشپردازش خودشان، تا اعداد دقت صادقانه بمانند.
آموزش بخشی روی لپتاپ خودم و بخشی روی Google Colab اجرا شد، که دسترسی رایگان GPUاش اجراهای سنگینتر را واقعبینانه کرد بهجای انتظارهای چندساعته روی CPU. سرانجام مدل در هر چهار طرف بهاندازهی کافی پایدار شد که در محیط عملیاتی به آن اعتماد شود.
سیمکشی نهایی
نسخهی تحویلشده یک سرویس FastAPI است که مدل آموزشدیدهی Ultralytics را پشت یک فرانتاند سادهی Next.js اجرا میکند — چهار عکس آپلود کنید، تشخیص را اجرا کنید، و یک JSON مفصل از هر پورت و اینکه روی کدام طرف است پس بگیرید — با MySQL که اینبار نتایج را برای محصول نهایی ذخیره میکند.
نتیجهی نهایی
اپلیکیشن تست پورت حالا برای هر لپتاپی که به آن داده شود، یک نقشهی پورت واقعی میگیرد، بدون تکیه بر یک فراخوانی سیستمعامل که قابلاعتماد نبود یا یک اسکرِیپر که دفاعهای بات یک تولیدکننده میتوانست خاموشش کند. تست واقعی اینکه آیا هر پورت تشخیصدادهشده کار میکند یا نه، مسئلهی جداگانهی خودش است — مسیری برای روزی دیگر.
چه چیزی از این تجربه یاد گرفتم
- APIهای اطلاعات سیستمی سطح سیستمعامل منبع حقیقت برای جزئیات سختافزاری مثل چیدمان پورت نیستند — جواب میدهند، فقط همیشه درست نیست.
- اسکرِیپ کردن سایتی که نمیخواهد اسکرِیپ شود، سقف دارد. زیرساخت بهتر در برابر دفاعهای بات زمان میخرد، سقف را برنمیدارد.
- وقتی یک وبسایت قابلاعتماد دادهی ساختاریافته نمیدهد، خواندن همان اطلاعات مستقیماً از روی عکس میتواند قابلاعتمادتر از ادامهی جنگیدن با سایت برای آن باشد.
- augmentation را با موارد شکست واقعی خودتان تطبیق دهید — چرخش، عکسهای چرخیده را درست کرد؛ فقط عکس خام بیشتر هرگز این کار را نمیکرد.